Artigo publicado
Roteamento de uma solicitação para outra máquina deve ser uma alteração de configuração, não uma reescrita
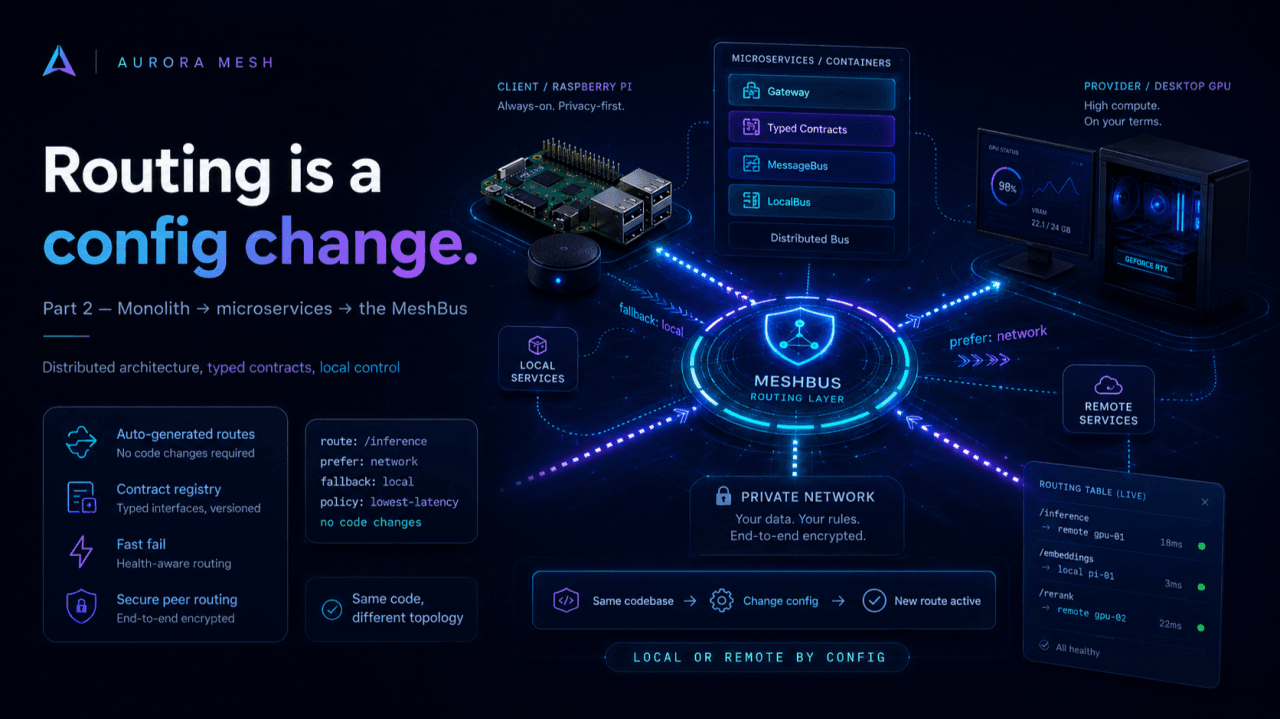
Roteamento de uma solicitação para outra máquina deve ser uma alteração de configuração, não uma reescrita. A arquitetura orientada por contrato que permite que o Aurora se divida em uma malha sem refatoração: um barramento, duas topologias e um gateway que se constrói por si mesmo.
- aurora
- distributed
- mesh
- infra
- architecture
Essa frase é toda a tese da arquitetura distribuída do Aurora. O momento em que "execute isso na GPU do meu desktop em vez deste Raspberry Pi" se torna um refatoramento, você perdeu. Tudo o que está abaixo é como eu o mantive como um valor de configuração.
A primeira parte desta série fez o caso de que um único dispositivo é um teto para a IA, e o caminho além dele é uma malha de suas próprias máquinas, em vez da nuvem. Este artigo aborda a engenharia por trás dessa afirmação: como o Aurora passou de um monolito local de processo único para um sistema de microsserviços baseado em contratos que pode rotear uma chamada para um peer sem que o chamador saiba.
Onde começou: um monolito feito para ser desmontado
O Aurora v1.0 era um único processo. A palavra de ativação alimenta a fala-para-texto, que alimenta um orquestrador LangGraph, que alimenta a fala-para-texto e o UI, com um SQLite e um armazenamento vetorial para RAG e uma camada de ferramentas de plugin/MCP ao lado. Cada capacidade era executada como uma thread dentro desse processo e se comunicava por meio de chamadas na memória. Era privado, era local e funcionava.
Também carregava as limitações que você esperaria. Um único processo significava uma única máquina, sem isolamento de falhas, sem forma de um segundo dispositivo se juntar e sem noção de identidade ou controle de acesso entre nós. Essas limitações são o que motivou o trabalho distribuído.
Uma decisão inicial tornou o resto possível. Mesmo como um monolito, as capacidades do Aurora eram executadas como serviços separados que se comunicavam por meio de um barramento de mensagens com contratos explícitos e tipados. Não chamadas de função que alcançavam os internos um do outro, mas mensagens. Essa disciplina transformou "torná-lo distribuído" em um problema de roteamento, em vez de uma reescrita.
Um barramento, duas topologias
A primeira abstração é o barramento de mensagens. Uma única interface MessageBus fica na frente de duas implementações:
- LocalBus, filas assíncronas asyncio na memória. Este é o "Modo Threads": tudo em um único processo, zero infraestrutura, ideal para desenvolvimento e uso em nó único.
- BullMQBus, filas respaldadas por Redis via workers BullMQ. Este é o "Modo Processos": cada serviço em seu próprio contêiner, pronto para ser executado em máquinas diferentes.
Os serviços não sabem em qual deles estão. O mesmo código que roda como threads em um laptop roda como contêineres separados em uma rede. Não há build "Lite" e build "Pro" e nenhuma base de código bifurcada, apenas uma implementação de barramento diferente selecionada por uma variável de ambiente (AURORA_ARCHITECTURE_MODE).
O barramento transporta três formatos de mensagem, que cobrem tudo o que o sistema faz:
- Comandos: ponto a ponto, com retry e uma fila de mensagens mortas para falhas.
- Eventos: pub/sub, melhor esforço, fire-and-forget.
- Consultas: request/response com timeout.
Um pequeno esquema de prioridade fica por cima. Interativo (10) vence Sistema (50) vence Externo (80), então uma solicitação ao vivo "Hey Aurora" salta à frente do trabalho em segundo plano, como transcrição ambiente. A entrega simultânea no LocalBus usa asyncio.gather(..., return_exceptions=True) para que um manipulador com falha não derrube os outros, e o caminho distribuído depende do Redis para confiabilidade. Um detalhe de implementação que me pegou e vale a pena roubar: no caminho BullMQ, uso filas reply.* efêmeras por solicitação e as removo após a resposta, pois uma implantação de longo prazo, de outra forma, vaza workers e filas até atingir o limite de descritores de arquivo do sistema operacional.
Contratos são a língua franca
Um barramento de mensagens só leva você até certo ponto se cada serviço falar seu próprio dialeto. O que torna uma chamada local e uma chamada remota idênticas é que o mesmo contrato descreve ambas.
Declaro cada método de serviço com um decorador @method_contract apoiado por modelos Pydantic para entrada e saída. Uma classe base BaseService registra automaticamente esses contratos na inicialização e inscreve automaticamente o serviço nos tópicos do barramento. O registro de contratos, que substituiu um registro de eventos mais antigo e solto, conhece cada método, seu esquema, sua exposição (interna, externa ou ambas) e seu tipo, uma operação "use" versus uma operação "manage".
Este registro é o cavalo de trabalho do sistema. A mesma definição de contrato faz três trabalhos:
- Ele valida e roteia mensagens no barramento.
- Ele gera a API HTTP automaticamente (mais abaixo).
- Ele sustenta uma chamada de procedimento remoto sobre a malha, pois um método que é apenas um contrato tipado chama da mesma forma em um peer quanto localmente.
Os contratos carregam um digest SHA-256 e uma versão semântica, que importa no instante em que dois dispositivos com builds diferentes tentam se comunicar. Eles exportam, importam e fazem round-trip, o que permite que um nó aprenda o que outro nó pode fazer.
O Gateway se constrói sozinho
Como cada serviço publica contratos, eu não escrevo a superfície HTTP à mão. O Gateway FastAPI gera suas rotas a partir do registro de contratos.
Um RegistryAggregator se inscreve nos eventos de anúncio e partida de serviços e mantém uma imagem ao vivo do que está disponível. Um RouteGenerator converte preguiçosamente esses esquemas Pydantic em rotas FastAPI com documentação OpenAPI gerada automaticamente. Quando um serviço se junta, seus endpoints aparecem. Quando ele sai, eles desaparecem, de modo que pares que entram e saem da malha não deixem um cemitério de rotas que resultam em 404. Uma aresta afiada para quem faz isso: tive que resolver $defs inline nos esquemas gerados para manter a saída OpenAPI válida.
O comportamento de falha também melhorou. No mundo antigo, uma chamada para um serviço que não existia ficaria presa até um timeout de 30 segundos. Com o registro rastreando presença, o Gateway falha imediatamente, com uma resposta de erro de aproximadamente 9 milissegundos em vez de uma paralisação de meio minuto. Falha rápida é um recurso.
O MeshBus: onde config-not-rewrite acontece
Agora vem o retorno. O MeshBus fica por cima do barramento de mensagens e intercepta cada mensagem. Ele contém uma tabela de roteamento que você configura, e para cada mensagem responde a uma pergunta. Esta vai para um serviço local ou para um peer remoto?
Como os serviços já se comunicam por meio de mensagens tipadas e contratos explícitos, enviar uma mensagem para outro dispositivo em vez de um manipulador local é uma pesquisa em uma tabela de roteamento, não um novo código no chamador. O orquestrador que pede uma transcrição não sabe nem se importa se o serviço STT é uma thread ao lado ou um contêiner em um Raspberry Pi do outro lado do cômodo. A chamada remota é JSON-RPC sobre um WebRTC DataChannel criptografado, assunto do próximo artigo, carregando os mesmos esquemas de contrato que o serviço usa internamente.
Mantenho duas preocupações de configuração separadas, pois conflitar elas é como os sistemas distribuídos vão tudo ou nada:
- Política de Compartilhamento: o que este dispositivo oferece à malha, com limites de capacidade. Sua área de trabalho pode compartilhar seu orquestrador pesado em GPU em max_concurrent: 2 e seu TTS em max_concurrent: 10, mantendo seu banco de dados local.
- Preferência de Roteamento: o que este dispositivo consome da malha. Seu telefone pode preferir a rede para orquestração, mas insistir na detecção local de palavra de ativação, onde a latência importa mais que a potência.
// Sharing Policy: what I offer
{ "Orchestrator": { "share": true, "max_concurrent": 2 },
  "TTS":          { "share": true, "max_concurrent": 10 },
  "DB":           { "share": false } }
// Routing Preference: what I consume { "Orchestrator": { "prefer": "network", "fallback": "local" }, "TTS": { "prefer": "local" }, "DB": { "prefer": "local" } } ```
Esses dois pequenos objetos permitem que você construa qualquer topologia que quiser: uma caixa poderosa na casa servindo LLM e TTS para clientes finos em todos os cômodos, uma máquina de trabalho emprestando suas capacidades ao seu telefone em movimento, dois amigos juntando hardware para superar o que qualquer um poderia fazer sozinho.
Projetando para a rede que você realmente tem
Sistemas distribuídos falham. Redes caem, dispositivos dormem, contêineres reiniciam. Aprendi isso da maneira tediosa, então toda regra de roteamento carrega um fallback:
{ "prefer": "network", "fallback": "local" }
Se o desktop ficar offline, o Pi continua funcionando recorrendo ao processamento local. Mais lento, menos capaz, ainda em execução. Quando o desktop voltar, o roteamento muda para a rede novamente, sem que o usuário precise fazer nada. O monolito já deu a você essa degradação graciosa local-first, e eu a mantive na transição para a distribuição, em vez de abri-la mão.
Os serviços também trocam manifestos de capacidade na conexão: versão, recursos suportados, capacidade. Se a versão do contrato de um peer for incompatível, o Gateway rejeita a conexão limpo na porta, em vez de falhar de forma confusa três chamadas depois. Verificações rígidas de compatibilidade antecipadas vencem a corrupção silenciosa downstream.
A lição principal
Você não obtém implantação agnóstica de topologia escrevendo código de rede em todo lugar. Você obtém isso pagando uma dívida cedo, fazendo seus componentes se comunicarem por meio de contratos tipados e versionados sobre um barramento de mensagens, então deixando uma camada fina de roteamento decidir por mensagem onde cada um roda. O mesmo binário Aurora roda como threads em um único processo, como contêineres em um único host ou como uma malha pela internet, e o código do aplicativo permanece idêntico. A diferença é a configuração.
Próximo na série: o transporte e o modelo de confiança. WebRTC DataChannels, emparelhamento de dispositivos no estilo Bluetooth, confiança bilateral e o sistema RBAC que decide quais de seus dispositivos podem pedir quais de seus outros dispositivos para o quê.
Aurora é de código aberto. Se você construiu sistemas orientados a contrato ou malha e resolveu esses problemas de forma diferente, quero comparar notas.
Publicado originalmente no LinkedIn.
Projetos relacionados: escrita pública