Artigo publicado
Seu assistente de IA privado tem um limite, e esse limite é o dispositivo no qual ele é executado
Executar IA localmente significa que um único dispositivo define seu limite. Por que assistentes locais-first ficam sem espaço, e como uma malha distribuída, controlada pelo usuário, de suas próprias máquinas aumenta esse limite sem abrir mão da privacidade.
- aurora
- ai
- privacy
- distributed
- local-first
Quando as pessoas dizem para você "apenas executar localmente", elas pulam a parte onde um único dispositivo é o limite.
Você pode executar detecção de palavra de ativação, fala-para-texto, texto-para-fala, embeddings e um LLM utilizável em hardware de consumo hoje. Eu construi tudo isso na primeira versão do Aurora e o uso diariamente. Mas toda vez que peguei meu telefone, entrei em outro cômodo ou pedi ao Raspberry Pi sempre ligado para fazer trabalho real, eu bati na mesma parede. A máquina na minha frente não era a máquina com o GPU.
Essa parede é o que este artigo trata, e por que o caminho além dela é uma malha dos seus próprios dispositivos, em vez da nuvem.
O dilema que todos são solicitados a engolir
Se você quer um assistente de IA capaz, a indústria oferece duas portas.
Por trás da primeira: assistentes de nuvem. Eles são capazes, convenientes e continuamente alimentados com seus dados. Seu áudio 24/7, suas transcrições, seu histórico de conversas e seus documentos são processados e frequentemente armazenados nos servidores de outra pessoa, geralmente atrás de uma assinatura mensal. Você aluga a inteligência e paga com a soberania sobre seus próprios dados.
Por trás da segunda: assistentes totalmente locais. Eles são privados por construção, nada sai da máquina, e são limitados pelo único dispositivo ao qual você está ao lado. Execute um modelo sério e seu laptop vira um aquecedor de ambiente. Execute-o em um Pi e você espera.
Essa tensão é o dilema privacidade-versus-capacidade. A maioria dos produtos resolve isso decidindo que a privacidade é a parte que você abre mão.
Por que o local-first acaba o espaço
O local-first atinge um teto rígido em um dispositivo.
Seu telefone não tem o GPU para executar um LLM decente. Seu desktop tem um, mas fica em outro cômodo, ou adormecido, ou desligado. Seu Raspberry Pi faz um ótimo microfone sempre ligado e mal consegue manter o modelo de transcrição aberto. Periféricos baratos como um Pi ou um ESP32 são pontos de acesso ideais, e ficam ociosos porque nenhum deles sozinho consegue executar todo o pipeline.
Assim, no momento em que você quer seu assistente em casa, no escritório e no bolso durante o deslocamento, o local-first te empurra de volta para um sistema distribuído. E a única opção distribuída que o mercado oferece é a nuvem. Assinaturas. Relés. "Confie seus dados conosco."
Eu queria uma terceira porta.
A terceira opção: poder distribuído, controle local
A ideia por trás da malha do Aurora é simples. Você já possui hardware suficiente para executar um assistente privado capaz. Ele apenas está espalhado entre dispositivos que não se comunicam.
Então deixe-os se comunicarem.
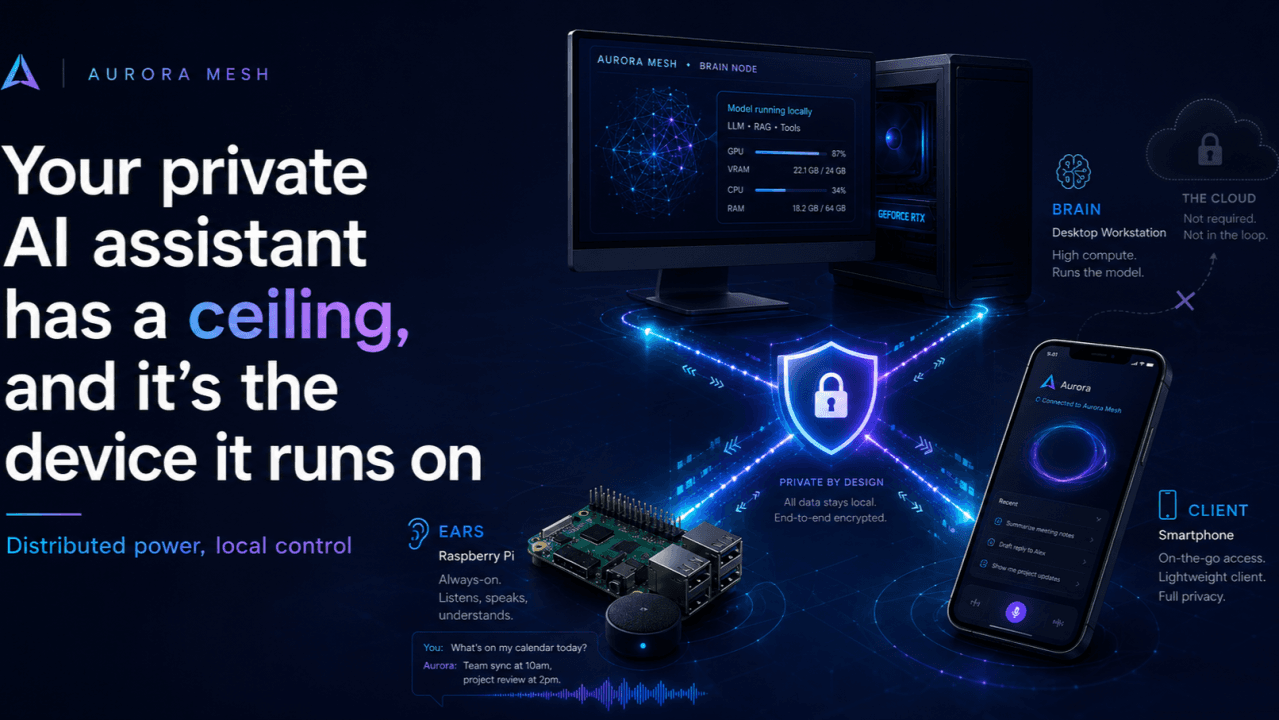
Deixe o desktop com o GPU ser o cérebro. Deixe o Raspberry Pi com o microfone ser os ouvidos. Deixe o telefone no seu bolso ser um cliente leve. Cada dispositivo contribui com o que faz bem, e juntos eles se comportam como um único assistente, uma "nuvem" privada de IA construída inteiramente a partir de máquinas que você possui.
Você decide o que cada dispositivo oferece, o que consome e quem pode acessar o quê. Nenhum servidor central armazena seus dados. Nenhum relé corporativo fica no meio de uma conversa. A única terceira parte no design inteiro é um servidor de sinalização STUN/TURN que ajuda dois de seus dispositivos a se encontrarem, e ele vê um endereço IP, nunca seu tráfego criptografado. Você pode hospedá-lo você mesmo, já que ele faz quase nada e custa quase nada.
O slogan do projeto é poder distribuído, controle local. Seu poder de computação cresce à medida que você adiciona hardware, em vez de ao fazer upgrade de um nível de assinatura. Seu assistente melhora porque você comprou um segundo dispositivo, não porque subiu de plano de preços.
Uma imagem concreta
Imagine uma solicitação normal. Você está na cozinha e diz "Ei Aurora, resuma meus e-mails não lidos."
O Pi na bancada ouve a palavra de ativação e transcreve você localmente. Ele não tem condições de executar um modelo de 12B parâmetros, então encaminha o raciocínio para a GPU do seu desktop através da sua própria rede. O desktop executa o LLM, chama a ferramenta de e-mail e envia a resposta de volta. O Pi a fala.
Do seu ponto de vista, parece perfeito. Você falou com o dispositivo barato, o caro fez o pensamento, e a resposta voltou através do alto-falante do dispositivo barato. O áudio, a transcrição e o conteúdo da sua caixa de entrada nunca saíram da sua rede. A distribuição lhe deu capacidade sem custar sua privacidade.
Por que isso importa agora
Estamos em um ponto de inflexão. Os modelos locais continuam melhorando em uma taxa surpreendente, a quantização continua reduzindo a barra de hardware, e os dispositivos de consumo vêm com silício dedicado de IA. Mantenha um pouco de sal perto, pois os LLMs locais pequenos de hoje ainda tropeçam na chamada confiável de ferramentas que um agente precisa, e eu direi isso antes de qualquer outra pessoa. Mas a trajetória se mantém.
O que faltava não eram os modelos ou os chips. Era a arquitetura para amarrar hardware de consumo heterogêneo e espalhado em algo coerente sem entregar o controle dos seus dados pelo caminho.
O modelo centralizado é conveniente e tem um custo de privacidade que muitas pessoas não querem mais pagar. O modelo totalmente local é privado e limitado a um dispositivo. A malha peer-to-peer fica no espaço entre eles, e esse espaço é onde a IA privada se torna prática.
O padrão vai além de assistentes de voz. Serviços baseados em contrato, roteamento transparente entre máquinas, confiança que você concede intencionalmente, compartilhamento que você controla por capacidade: esse formato se encaixa em quase qualquer carga de trabalho de IA que você queira manter privada enquanto ainda a distribui por mais de uma máquina.
Esta é a primeira parte de uma série curta sobre como a malha distribuída do Aurora funciona. Depois eu entro na engenharia: como um monolito local se tornou um sistema de microsserviços baseado em contrato, e como uma camada de roteamento chamada MeshBus transforma "execute isso em outro dispositivo" em um valor de configuração.
Aurora é gratuito e de código aberto. Se a ideia de uma IA distribuída, privado, controlado pelo usuário que você realmente possui fizer sentido para você, quero ouvir o que você construiria com ele.
Publicado originalmente no LinkedIn.
Projetos relacionados: escrita pública