Artigo publicado
Aurora, a faca suíça dos assistentes de voz
Aurora é meu assistente de voz open-source, local-first: palavra de ativação, 24/7 transcrição opt-in, orquestração de chamada de ferramentas, suporte a MCP, memória RAG, agendamento e uma malha distribuída, tudo rodando no seu próprio hardware.
- aurora
- ai
- voice
- agents
- privacy
O que ele pode fazer atualmente?
- Ouvir comandos de voz em segundo plano;
- Opcionalmente transcrever áudio 24/7, permitindo resumos diários (opt-in e 100% local);
- Chat UI interativo para respostas longas e troca/ativação de texto;
- Chatbot orquestrador que pode chamar ferramentas e raciocinar sobre sua funcionalidade para atender às solicitações do usuário;
- Manter conversas e chats contextuais;
- Armazenar informações que o assistente considera importantes sobre o usuário, para que possa usá-las a longo prazo;
- Sistema de agendamento e cronjob que permite lembretes, eventos, timers e ferramentas integradas como o Pomodoro.
- Responder às solicitações do usuário usando voz (TTS) bem como texto através do UI;
- Sistema de ferramentas extensível, fácil de codificar suas próprias ferramentas;
- Suporte para ferramentas do Model Context Protocol (MCP), o que significa configuração fácil para grandes integrações e suporte a um ecossistema em constante expansão;
- Geração Aumentada por Recuperação (RAG), usada para aprimorar o conhecimento do agente buscando memórias relevantes à solicitação do usuário; também é usada para corresponder apenas às ferramentas relevantes por solicitação. Você pode adicionar quantos plugins quiser sem estourar suas janelas de contexto ou correr o risco de envenenamento de contexto.
Como ele é privado?
- Ouvir uma palavra de ativação personalizável (Ex: Jarvis, Aurora) usando OpenWakeWord ou Porcupine;
- Quando uma palavra de ativação é detectada, transcrever a solicitação do usuário usando um modelo Whisper;
- Respostas de texto para fala locais usando Piper, escolha entre muitas vozes diferentes (e qualidades de voz);
- Embeddings para RAG podem ser da OpenAI ou modelos de embedding locais do Hugging Face;
- Tudo feito localmente em hardware de consumo; não é necessário GPU em modelos menores;
E o Cérebro? Pode rodar em LLMs locais? Sim (tipo), há atualmente suporte integrado para executar modelos de código aberto através do Hugging Face e Llama.Cpp para modelos quantizados, bem como executá-lo na nuvem nos endpoints da OpenAI e Hugging Face.
Detecção de Palavra de Ativação
A detecção de palavra de ativação foi principalmente construída usando a abstração de lib RealtimeSTT, ela usa Porcupine ou OWW (Open Wake Word) por baixo dos panos, ambos são modelos extremamente leves que permitem o reconhecimento de uma palavra específica como Jarvis, Aurora, Alexa, etc, enquanto são processados em tempo real dentro da CPU.
O mais recente (OWW) permite o treinamento fácil de novas palavras de ativação, assim você pode até personalizar a forma como chama seu assistente.
Aurora ouve 24/7 em segundo plano completamente localmente, passando o áudio por este modelo, detectando ou não a presença de uma palavra de ativação, e descartando imediatamente o áudio logo após.
STT (Fala para Texto)
O STT também foi principalmente baseado no módulo RealtimeSTT, que usa faster-whisper e Silero VAD para detecção de atividade de voz por baixo dos panos, mas foi eventualmente migrado para sua própria implementação direta usando ambos os modelos mencionados anteriormente para ter melhor flexibilidade e suportar mais recursos (como transcrição ambiente).
É configurável para que você possa escolher o tamanho do modelo whisper que deseja executar dependendo do seu hardware, idioma preferido, qualidade de transcrição e trade-offs de desempenho.
Transcrição Ambiente
A transcrição ambiente é opcional e, quando ativada, essencialmente redireciona a entrada de áudio 24/7 através do modelo TTS bem como o modelo de palavra de ativação, descartando o áudio e armazenando as transcrições, seja em um arquivo ou dentro do banco de dados (configurável) para acesso posterior pelo assistente.
O processo de transcrição ambiente processa o áudio em blocos através de uma fila de prioridade que serve como controle de acesso ao modelo faster-whisper, sempre que uma palavra de ativação é detectada, ela tem prioridade maior sobre os blocos de transcrição ambiente, que são então processados posteriormente após a solicitação de palavra de ativação ser atendida, garantindo que a responsividade do assistente não seja comprometida.
TTS (Texto para Fala)
O módulo TTS também é baseado no RealtimeTTS, uma segunda lib da família focada em TTS, especialmente devido à sua modularidade e rico ecossistema de opções com suporte a plug-ins para diferentes modelos locais de TTS.
O principal atualmente usado é o PiperTTS, devido às suas características multiplataforma, grande variedade de qualidades de síntese de voz e suporte a idiomas.
Suporte para provedores de nuvem e outros locais também está chegando em breve.
RAG (Geração Aumentada por Recuperação) e Embeddings
RAG serve a múltiplos propósitos dentro do Aurora;
Primeiramente, é usado pelo agente principal para armazenar informações importantes e memórias sobre os usuários, para que possa aprender a longo prazo e usá-las sempre que apropriado, dependendo da solicitação do usuário. Isso é persistente e de longo prazo, diferente do histórico específico de thread/conversa de mensagens que o agente também acessa, permitindo uma conversa multi-turno e contínua.
Em segundo lugar, é usado para corresponder ferramentas do sistema de ferramentas, permitindo o crescimento do ecossistema de ferramentas do usuário sem limites ou restrições devido ao tamanho da janela de contexto e ao envenenamento de contexto, o que seria inerente se todas as ferramentas do sistema fossem enviadas para cada solicitação. (Isso, no entanto, traz seu próprio conjunto de desafios, que serão melhor abordados por agentes especializados no futuro)
Os provedores de embedding atualmente suportados são OpenAI (Nuvem) e Hugging Face (Local), llama.cpp também está chegando para modelos quantizados.
Sistema de Ferramentas
O sistema de ferramentas suporta a adição fácil e modular de plugins diretamente do rico ecossistema langchain. Há milhares de ferramentas e kits de ferramentas disponíveis. Ao usar a definição padrão de ferramentas do framework, também é fácil estender e criar ferramentas personalizadas através de código para aqueles que são um pouco experientes em tecnologia.
Além dos plugins/tooling padrão, o Aurora também suporta o MCP, o maior ecossistema de plugins para LLMs à sua disposição. Ele suporta servidores locais (stdio) bem como remotos (http, sse, websocket). *Suporte a OAuth em breve.
Ele também suporta a descoberta do MCP, significando que você pode facilmente adicionar servidores MCP já configurados de outros clientes dentro do seu computador, como Claude Code, Cursor, Copilot, etc.
Cérebro
O cérebro e a orquestração dependem dos frameworks LangGraph e LangChain para construir o principal Chatbot e suas interações com ferramentas e outros agentes.
Ele atualmente suporta chamada de ferramentas através de modelos OpenAI, modelos quantizados llama.cpp (usando templates de chat para LLMs que não chamam ferramentas nativamente) e Hugging Face (local e nuvem).
Isso também significa que o Aurora pode muito facilmente crescer para suportar múltiplos outros provedores de LLM usando o ecossistema de plug-ins do langchain, sejam eles baseados em nuvem (Anthropic, Gemini, Grok) ou locais (Ollama, llamafile, vLLM).
LangGraph pode parecer excessivo já que o projeto atualmente tem apenas um agente principal de Chatbot simples que pode raciocinar sobre chamadas de ferramentas e resultados até que a solicitação do usuário seja concluída, porém foi construído com o propósito de extensibilidade, pois o lema do Aurora é permitir personalização, lançamentos futuros visarão uma arquitetura de agentes profundos especializados e supervisionados, com a capacidade de alocar ferramentas específicas para esses especialistas, permitindo ações e raciocínios muito mais complexos em seu nome.
Pitaco sobre LLMs locais
A taxa de desenvolvimento de modelos tem sido assombrosa em muitas áreas; conseguir executar detecção de palavra de ativação, TTS, STT, e modelos de embedding de uma só vez em hardware de consumo já é uma grande conquista.
No entanto, LLMs ainda não estão lá; ainda requer pelo menos uma GPU de entrada para conseguir rodar os modelos menores localmente com tempos de resposta razoáveis. Eu mesmo tenho testado em uma GPU discreta de notebook (RTX 3050 4GB).
Muitos modelos excelentes podem rodar em GPUs de entrada, especialmente quando quantizados e com suporte a camadas, como a família Gemma 3 12B. Porém, na minha experiência, nenhum deles é bom o suficiente ainda para suportar consistentemente a chamada de ferramentas, uma parte essencial do fluxo de trabalho agente do Aurora. Temos suporte para isso, no entanto, para aqueles que desejam testar modelos maiores. Gemma 3 27B, por exemplo, deve funcionar razoavelmente bem.
Tudo não está perdido, porém; o desenvolvimento de capacidades para modelos pequenos serem implantados em dispositivos de consumo acelerou, muitas novas técnicas e otimizações emocionantes estão surgindo, e em breve teremos um modelo bom o suficiente para rodar corretamente em hardware de consumo GPU, quem sabe, talvez até na CPU. Um bom exemplo disso é o modelo totalmente novo Gemma 3n.
Devo usar o Aurora?
Embora o objetivo do projeto seja ser amigável para iniciantes, ele ainda não está em um ponto onde não-desenvolvedores possam configurar/utilizar facilmente todas as suas capacidades.
Desenvolvedores e entusiastas de tecnologia são mais que bem-vindos para experimentá-lo, dar feedback ou até contribuir.
Visão de longo prazo
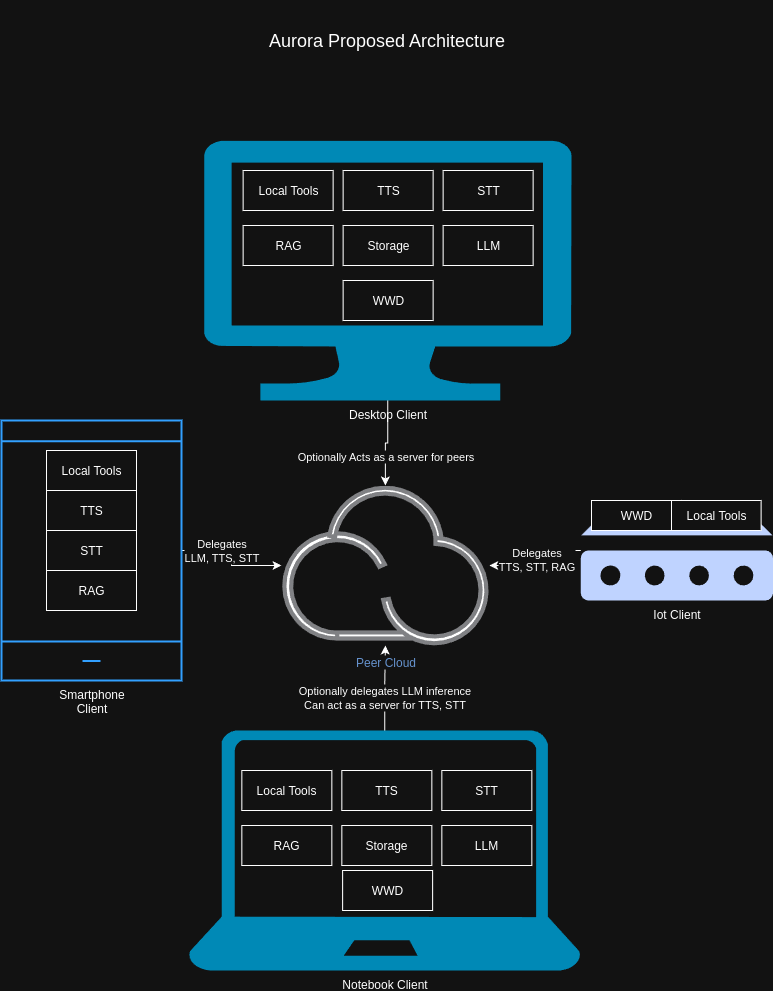
Os conceitos centrais por trás do Aurora, além de sua riqueza de capacidades, são acessibilidade e privacidade, e como tal, os próximos passos do projeto focarão em torná-lo utilizável entre dispositivos e plataformas.
Atualmente, uma reformulação de arquitetura está em andamento, com o propósito de suportar uma arquitetura cliente-servidor para uso adequado mesmo em dispositivos menos poderosos.
A nova arquitetura permitirá o processamento paralelo das múltiplas funcionalidades e auto-hospedagem de um servidor privado, bem como suporte a protocolos P2P para usuários que simplesmente desejam rodar o assistente em hardware mais forte e acessá-lo facilmente de múltiplos dispositivos (smartphones incluso) pela internet sem o incômodo de configurar um servidor IP público.
Uma reformulação da UI também está planejada, a atual foi construída como uma prova de conceito usando PyQT6 para interfaces multiplataforma, porém o plano é também suportar adequadamente Android e iOS.
https://github.com/joaojhgs/aurora
Originalmente publicado em LinkedIn.
Projetos relacionados: escrita pública